Teil B · Wie Maschinen lernen · Lektion 5
Wie eine Maschine lernt
Geprüft am 20.11.2026
Lernen heißt: Parameter so lange verstellen, bis die Vorhersagen auf den Trainingsbeispielen möglichst wenig falsch sind.
Einem Kind erklärt niemand per Regel, was einen Hund von einer Katze unterscheidet. Es sieht viele Tiere, jemand sagt „Hund“ oder „Katze“, das Kind liegt manchmal falsch, wird korrigiert – und irgendwann erkennt es neue Tiere sicher.
Ein Modell ist eine Rechenvorschrift mit vielen Stellschrauben, den Parametern. Beim Training vergleicht das Verfahren die Vorhersagen mit den richtigen Antworten, misst den Fehler (Verlust, englisch loss) und verstellt die Parameter so, dass der Fehler kleiner wird. Das wiederholt sich viele Male.
Die Bausteine des Lernens
- Modell wählen – z. B. eine Gerade y = b₀ + b₁·x. Die Parameter b₀ und b₁ sind noch unbekannt.
- Vorhersagen für alle Trainingsbeispiele berechnen.
- Fehler messen mit einer Verlustfunktion, z. B. dem mittleren quadratischen Fehler.
- Parameter anpassen in die Richtung, in der der Fehler sinkt (Gradientenabstieg, Modul 3).
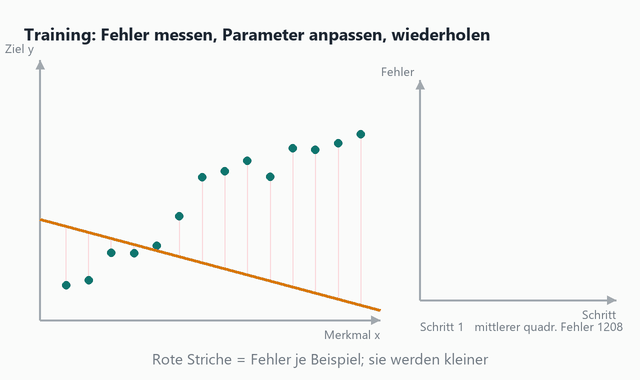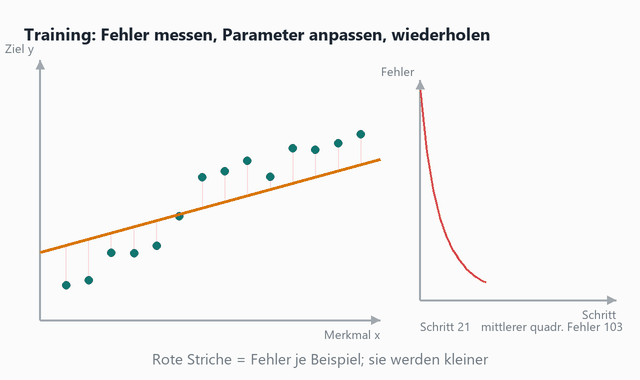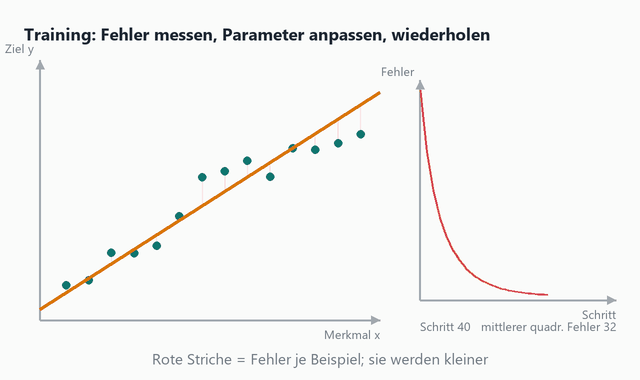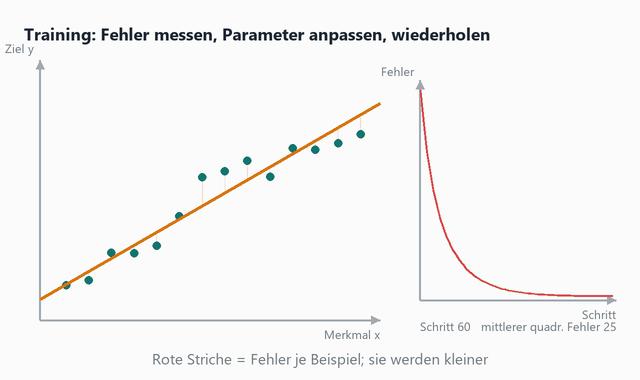
- Wiederholen, bis der Fehler nicht mehr deutlich sinkt.
Parameter lernt das Modell selbst. Hyperparameter legen Menschen vorher fest – etwa wie schnell gelernt wird (Lernrate) oder wie tief ein Entscheidungsbaum werden darf.
Lernen heißt: Parameter so lange verstellen, bis die Vorhersagen auf den Trainingsbeispielen möglichst wenig falsch sind.
„Erklären Sie den Unterschied zwischen Parameter und Hyperparameter“ ist eine Standardfrage. Kurz: Parameter werden gelernt, Hyperparameter werden vorgegeben.
Hinweise für Lehrende
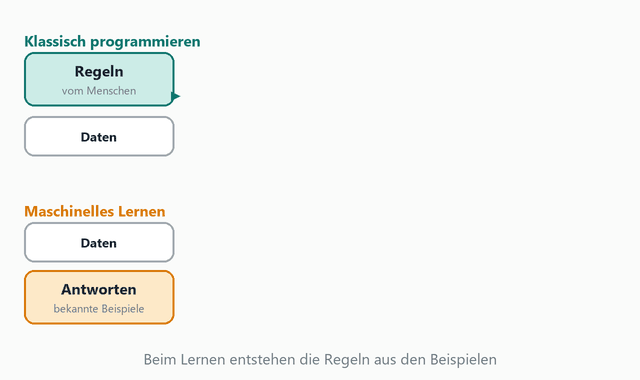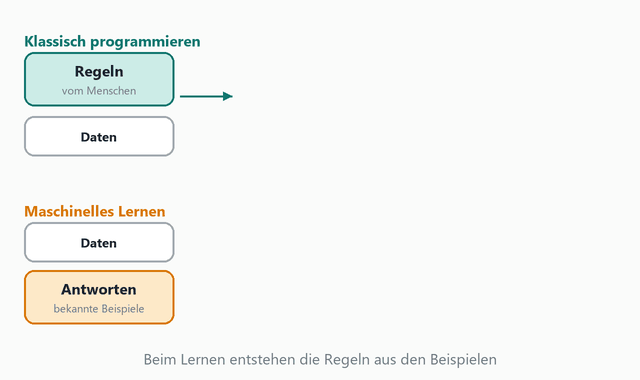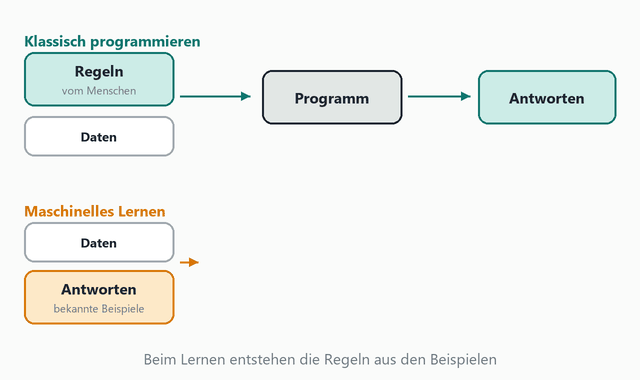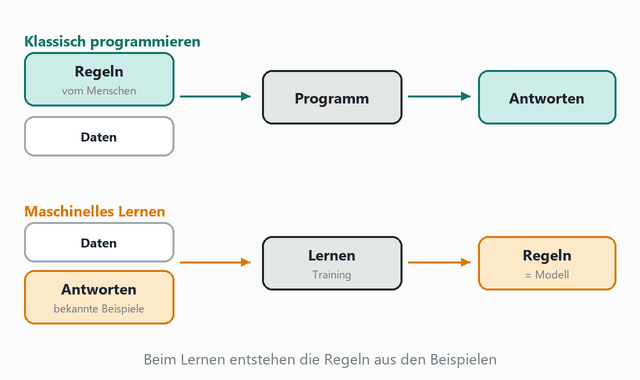
Zeigen Sie zuerst die obere Animation und betonen Sie die Umkehrung: Beim maschinellen Lernen sind die Regeln das Ergebnis. Dann die Trainingsanimation: Die roten Striche sind die Fehler je Beispiel. Fragen Sie: „Wann ist die Gerade fertig?“ – Wenn der Fehler kaum noch sinkt.
Häufige Fragen zu „Wie eine Maschine lernt“
Wie lernt eine Maschine?
Ein Modell macht Vorhersagen für Trainingsbeispiele, misst mit einer Verlustfunktion, wie falsch sie sind, und verstellt seine Parameter so, dass der Fehler sinkt. Das wiederholt sich, bis der Fehler kaum noch kleiner wird.
Was ist der Unterschied zwischen Parameter und Hyperparameter?
Parameter lernt das Modell beim Training selbst, zum Beispiel Gewichte. Hyperparameter legt der Mensch vorher fest, zum Beispiel die Lernrate oder die maximale Tiefe eines Entscheidungsbaums.
Was ist eine Verlustfunktion?
Eine Verlustfunktion misst, wie stark die Vorhersagen von den richtigen Antworten abweichen, etwa als mittlerer quadratischer Fehler. Das Training versucht, diesen Wert zu minimieren.