Teil B · Wie Maschinen lernen · Lektion 6
Training, Validierung, Test
Geprüft am 20.11.2026
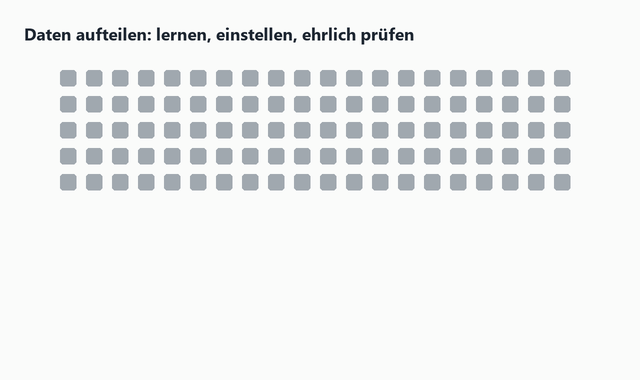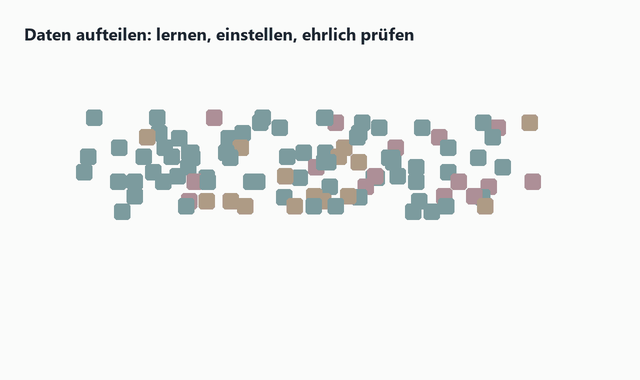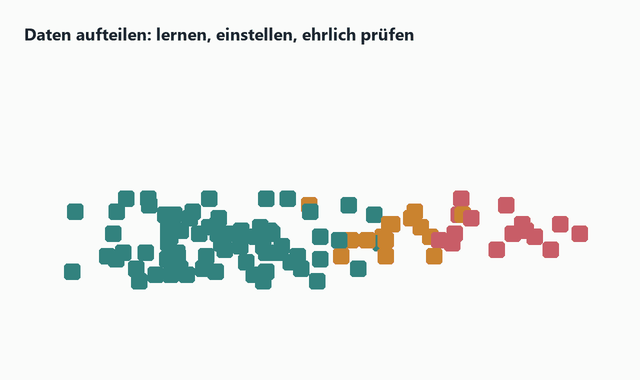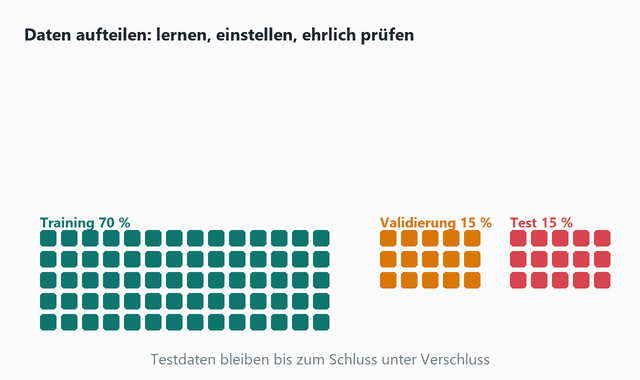
Testdaten sind wie die echte Prüfung: Sie bleiben bis zum Schluss verschlossen – sonst ist das Ergebnis geschönt.
Wer für eine Prüfung nur die Musterlösungen auswendig lernt, schreibt eine glatte 1 – solange genau diese Aufgaben drankommen. Bei neuen Aufgaben fällt er durch. Ehrlich ist nur eine Prüfung mit Aufgaben, die man vorher nicht gesehen hat.
Die Daten werden vor dem Training aufgeteilt: Trainingsdaten zum Lernen der Parameter, Validierungsdaten zum Einstellen der Hyperparameter und zum Vergleichen von Modellen, Testdaten nur ganz am Ende für eine ehrliche Schätzung, wie gut das Modell bei neuen Fällen ist.
Was dabei schiefgehen kann
| Begriff | Was passiert | Erkennbar an |
|---|---|---|
| Overfitting (Überanpassung) | Modell lernt Trainingsbeispiele samt Zufall auswendig | Training sehr gut, Test deutlich schlechter |
| Underfitting (Unteranpassung) | Modell ist zu einfach für den Zusammenhang | Training und Test schlecht |
| Data Leakage | Informationen aus den Testdaten oder aus der Zukunft gelangen ins Training | Unglaublich gute Testwerte, später Enttäuschung im Betrieb |
Bei Zeitreihen (z. B. Absatz je Woche) wird nicht zufällig, sondern zeitlich getrennt: mit der Vergangenheit trainieren, mit dem jüngsten Zeitraum testen. Sonst „kennt“ das Modell die Zukunft.
Testdaten sind wie die echte Prüfung: Sie bleiben bis zum Schluss verschlossen – sonst ist das Ergebnis geschönt.
„Wir haben auf allen Daten trainiert und auf allen Daten 99 % erreicht.“ Diese Zahl sagt nichts darüber, wie gut das Modell neue Fälle erkennt. In Situationsaufgaben wird genau dieser Fehler gern versteckt.
Kurz geprüft: Ein Modell erreicht 99 % im Training und 72 % im Test. Was liegt vor?
Hinweise für Lehrende
Das Prüfungsbeispiel mit der Musterlösung bleibt hängen. Ergänzen Sie: Validierungsdaten sind wie Probeklausuren – man darf sich an ihnen orientieren, aber dann sind sie „verbraucht“ und taugen nicht mehr als ehrliche Endprüfung. Details zu Kreuzvalidierung folgen in Modul 4.
Häufige Fragen zu „Training, Validierung, Test“
Warum teilt man Daten in Training, Validierung und Test auf?
Mit Trainingsdaten lernt das Modell, mit Validierungsdaten werden Einstellungen gewählt und Modelle verglichen, und mit Testdaten wird am Ende ehrlich geschätzt, wie gut das Modell bei neuen Fällen ist.
Was ist Overfitting?
Overfitting heißt, dass ein Modell die Trainingsbeispiele samt Zufall auswendig lernt. Es ist im Training sehr gut, bei neuen Daten aber deutlich schlechter.
Wie teilt man Zeitreihen richtig auf?
Zeitlich: mit älteren Daten trainieren und mit dem jüngsten Zeitraum testen. Bei einer zufälligen Aufteilung würde das Modell im Training schon Informationen aus der Zukunft sehen.